
Il existe un dicton dans l’armée : « Les amateurs parlent de tactique, mais les professionnels étudient la logistique. » Cette idée peut sembler surprenante à première vue, lorsque l’on songe au brio de Lee à Chancellorsville ou au génie d’Hannibal pendant les guerres puniques. Pourtant, l’histoire retient que ni Lee ni Hannibal n’ont remporté leurs guerres respectives. La principale raison en était la logistique : la capacité à approvisionner une armée en nourriture, en vêtements et en armes, au bon moment et au bon endroit. Malgré des tactiques brillantes, c’est finalement la logistique qui a décidé de la victoire. Autrement dit, la tactique permet de tirer le meilleur parti des moyens dont on dispose sur le terrain, mais c’est la logistique qui permet avant tout d’y être et d’y rester.
J’aime l’analogie militaire, car je trouve qu’elle fait écho à la manière dont les solutions fondées sur les données sont souvent présentées aujourd’hui. Le prestige de la « tactique » — les techniques avancées d’IA telles que l’apprentissage profond, la classification par forêts aléatoires, le boosting de gradient, etc. — éclipse régulièrement la « logistique », moins séduisante, que constituent les fondations de l’architecture des données indispensables à la mise en œuvre de ces techniques avancées.
La première étape d’une réflexion sur l’architecture des données consiste à définir ce que recouvre ce concept. Sans surprise, la réponse est nuancée : l’architecture des données comporte plusieurs niveaux et de multiples facettes. Pour donner un cadre concret à cette réflexion, il est utile de commencer par l’envisager sous l’angle du parcours des données de télémétrie collectées. Le schéma ci-dessous présente une vue d’ensemble d’un pipeline de données et met en évidence les points de contact entre ce pipeline et les fondements de l’architecture des données.
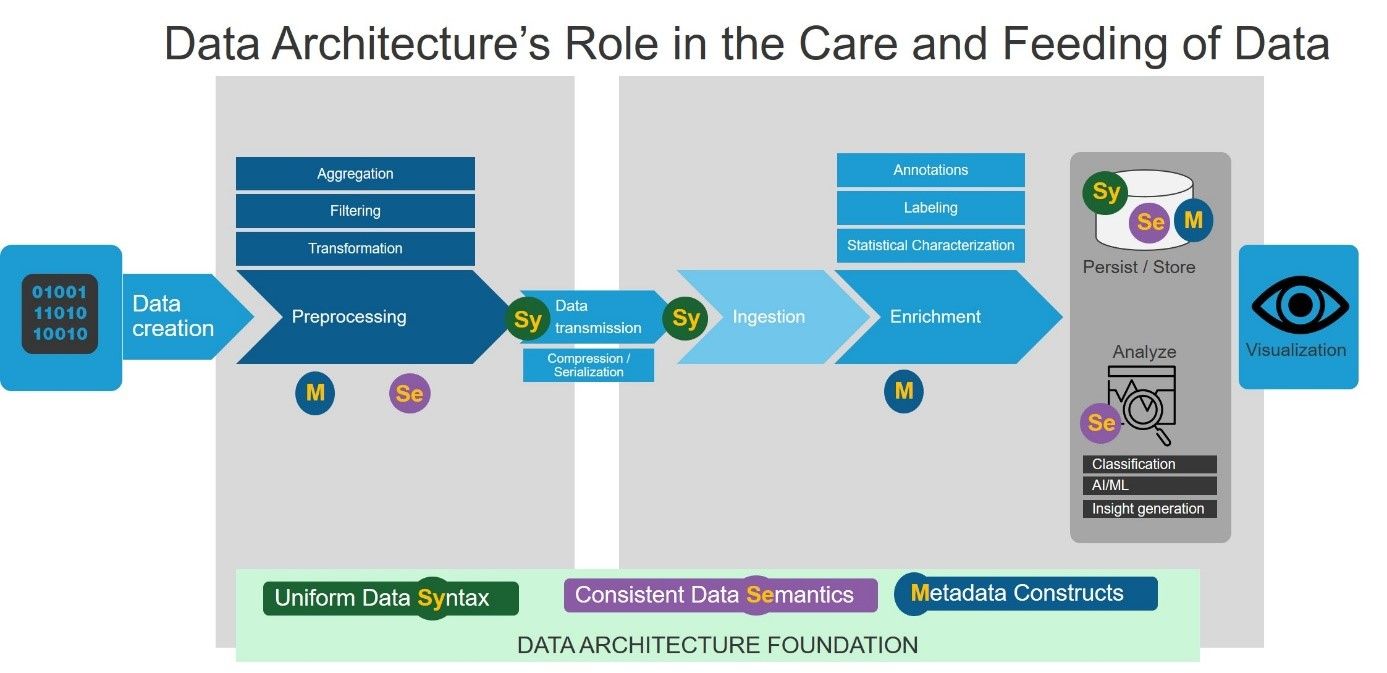
Le parcours de chaque élément de données commence par sa création, souvent suivie d’un certain prétraitement avant sa sérialisation et sa transmission à un collecteur/agrégateur de données, généralement hébergé dans le cloud. Le collecteur de données peut ensuite, après désérialisation et ingestion, effectuer des traitements et des enrichissements supplémentaires avant de transmettre les données à un stockage persistant et/ou d’alimenter un pipeline d’analyse de données. Enfin, les résultats enrichis/analysés sont mis à la disposition des utilisateurs au moyen d’une plateforme de visualisation et peuvent même être exploités par des systèmes automatisés sous forme de données de rétroaction destinées à des systèmes en boucle fermée capables de s’autorégler ou de s’autoréparer.
Maintenant que le contexte du pipeline de données est établi, nous pouvons revenir à la question de savoir ce que l’on entend par « architecture des données ». La première réponse, au niveau le plus superficiel, porte sur la représentation des données et la syntaxe de sérialisation. Par exemple, si un événement de données contient un champ d’objet intitulé « customer », la vue syntaxique détermine si ces données sont représentées sous la forme d’une chaîne de caractères, d’un UUID entier ou d’un autre type.
Cependant, si nous approfondissons un peu, une deuxième réponse va au-delà de la simple syntaxe : elle concerne la sémantique des données, c’est-à-dire une interprétation bien définie et cohérente de leur contenu. Reprenons l’exemple du champ « customer » et supposons que la question syntaxique ait été résolue, autrement dit que l’élément de données ait effectivement été défini comme un champ de type chaîne de caractères. L’architecture des données doit ensuite pouvoir répondre à la question du sens et de l’interprétation : s’agit-il du nom d’une personne ou de celui d’une entreprise ? S’il s’agit du nom d’une personne, correspond-il à <last-name>, à <first-name> ou aux deux ? Associée à une syntaxe uniforme, une sémantique cohérente permet au pipeline de données d’exécuter de manière générique et robuste des fonctions telles que le filtrage et l’agrégation des données, en s’appuyant sur une interprétation logique cohérente de leur contenu. En outre, le magasin de données peut facilement exécuter des requêtes fédérées sur différentes instances du pipeline de création de données, à condition que les données créées respectent une syntaxe et une sémantique cohérentes.
Enfin, en approfondissant encore, il est souvent important que l’architecture des données dispose d’une troisième capacité : un vocabulaire permettant de contextualiser la télémétrie et de raisonner sur les données elles-mêmes — le vocabulaire des métadonnées. Cet aspect est particulièrement important dans le cadre des exigences de gouvernance des données d’entreprise, qu’il s’agisse de conformité, d’audit ou même de processus internes nécessitant une compréhension globale des données gérées au sein d’un entrepôt de données. Les métadonnées prennent souvent la forme d’annotations associées aux données, lesquelles respectent le même type de cohérence syntaxique et sémantique que les données elles-mêmes. Par exemple, des champs de métadonnées seraient probablement utilisés pour consigner l’identité de la source des données ainsi que la chronologie du traitement de toutes les données collectées, afin de respecter les exigences légales en matière de conservation des données.
Une autre façon d’utiliser les champs de métadonnées dans le lexique d’un schéma de description des données consiste à caractériser certains aspects des champs de données eux-mêmes, tels que la cardinalité d’un élément de données ou son degré de sensibilité en matière de confidentialité. Reprenons une dernière fois notre exemple du champ de données « client » : les annotations de métadonnées du schéma de données pourraient indiquer que l’élément de données est unique, tandis que des annotations supplémentaires, dans le contexte d’un flux de données (par exemple, pour des transactions d’achat au détail), pourraient indiquer que les éléments de données sont obligatoires et uniques—autrement dit, les métadonnées serviraient à préciser que le champ customerID doit être unique (et peut donc servir de clé primaire de base de données) et que chaque événement d’achat doit être associé à un et un seul customerID. L’intérêt de l’ensemble des fonctionnalités de métadonnées, dans le contexte du pipeline de données, réside dans le fait qu’elles peuvent être exploitées pour ajouter des annotations relatives à la conformité des données, fournir un lexique d’enrichissement des données et permettre des workflows de gouvernance flexibles pour l’entrepôt de données.
En résumé, la réponse à la question « Qu’est-ce que l’architecture des données ? » est qu’elle consiste, au minimum, à fournir un cadre garantissant la cohérence, tant syntaxique que sémantique, des données collectées. En outre, une architecture des données robuste doit également intégrer une stratégie de métadonnées suffisamment puissante pour non seulement définir des contraintes sur les données, mais aussi permettre de raisonner sur les données elles-mêmes.
Lorsqu’elle est considérée comme un domaine d’intérêt à part entière et qu’elle est correctement mise en œuvre, une architecture de données s’apparente donc beaucoup à une bonne infrastructure logistique militaire. Comme dans le contexte militaire, elle fournit un socle qui démultiplie l’efficacité et la robustesse de tous les composants des systèmes qui reposent sur elle, permettant ainsi à ces systèmes plus visibles d’être mobilisés avec une efficacité maximale. Dans le contexte d’un système de traitement des données, ce socle architectural permet de mettre en place des modèles de gouvernance des données plus souples et plus puissants, de faciliter le partage des données entre différentes sources grâce à un entrepôt de données robuste et d’adopter une approche plus réactive pour intégrer de nouveaux flux de données afin d’améliorer l’agilité de l’entreprise.
À propos de l’auteur
Articles de blog associés
Pourquoi devriez-vous vous intéresser à WebAssembly ?
WebAssembly (Wasm) est un jeu d’instructions binaires portable, rapide et sécurisé, qui permet d’exécuter des applications hautes performances sur n’importe quelle plateforme.
Trois choses à savoir sur les applications d’IA
Les applications d’IA sont des applications modernes, mais elles présentent certaines particularités. Découvrez les points essentiels à connaître sur les applications basées sur l’IA.
État des lieux de la stratégie applicative 2022 : il est temps de moderniser les opérations
Il est devenu évident que, pour maintenir la dynamique de leur transformation numérique, les organisations doivent recentrer leurs efforts sur les fonctions métier. Si les expériences destinées aux clients restent prioritaires, il est également indispensable de permettre la numérisation de fonctions telles que les services juridiques, les ressources humaines et la finance. Les DSI prennent donc les commandes, tandis que la transformation numérique passe de la modernisation des applications à celle des opérations.
Clouds multiples ou multicloud : faciliter la transition
La gestion et la sécurisation des charges de travail deviennent complexes à mesure que les entreprises adoptent une stratégie de cloud connecté. Découvrez comment F5 répond au besoin d’une nouvelle approche de la mise en réseau multicloud.
L’expérience client dépend de la visibilité
Une enquête menée par Dimensional Research auprès de plus de 3 000 utilisateurs d’applications mobiles a confirmé ce que beaucoup d’entre nous pensent des attentes actuelles des clients.
Transformation numérique et explosion du portefeuille d’applications
La transformation numérique stimule la croissance des portefeuilles d’applications et modifie la manière dont celles-ci sont développées, déployées, intégrées et, en définitive, utilisées.